2026 CEDEC 2026 講演資料
宝可梦 Z-A 的 CI/CD 容器化实践
髙山玲央名
GAME FREAK 讲述将《宝可梦》系列 CI/CD 从公有云 VM 迁移到 Kubernetes 与 Windows 容器的历程。
摘要
过去《宝可梦》系列的 CI/CD 依赖公有云 Windows Server 虚拟机,存在环境更新繁琐、状态难以保证、费用高昂与运行时间受限等课题。在《宝可梦传说 Z-A》开发中,团队引入 Kubernetes 与 Windows 容器,实现按作业自动扩缩、环境代码化与安全隔离,并克服镜像获取耗时、网络稳定性与费用增加等导入难题,最终在发售前持续运用并改善了原有课题。
『Pokémon LEGENDS Z-A』における Kubernetes × Windowsコンテナ を活用したCI/CDの構築事例 株式会社ゲームフリーク 髙山 玲央名
《宝可梦传说 Z-A》中 利用 Kubernetes × Windows 容器 构建 CI/CD 的实例 GAME FREAK 株式会社 髙山 玲央名
本講演について
- 撮影・SNS投稿はOKです
- Ask the Speakerの場を設けております
- 資料はCEDiLに公開を予定しています
关于本讲演
- 可以拍照和发社交媒体
- 设有 Ask the Speaker 环节
- 资料计划在 CEDiL 上公开
はじめに
- 本講演では、『ポケットモンスター』シリーズ開発のCI/CD ビルド環境を パブリッククラウドの仮想マシン(VM)からWindowsコンテナ(Kubernetes)に移行し た話をします。
- Windowsコンテナに移行した経緯、移行する上で直面した課題、実際に移行して 得られた成果をお伝えできればと思います。
- Windowsコンテナは機能としては2016年にリリースされたものの、実践的な事例は 決して多くありませんので、1つの参考になれば幸いです。 本講演では、表記の都合により『Pokémon LEGENDS Z-A』をZ-Aと略記します。
引言
- 本讲演将介绍将《宝可梦》系列开发的 CI/CD 构建环境 从公有云的虚拟机(VM)迁移到 Windows 容器(Kubernetes) 的经历。
- 希望向大家分享迁移到 Windows 容器的经过、迁移过程中遇到的课题以及实际迁移后取得的成果。
- Windows 容器虽然功能早在 2016 年就已发布,但实践案例 绝不算多,希望能作为一个参考。 本讲演中,为表述方便,将《宝可梦传说 Z-A》简称为 Z-A。
- 所属:研究開発部 環境セクション
- 2020年 ビルドエンジニアとしてゲームフリークに入社
- 『ポケットモンスター』シリーズ開発のCI/CD構築やツール開発に横断的に携わる
- 現在は主に開発インフラのサービスレベル改善・セキュリティ強化・コスト最適化を担当 自己紹介 / 髙山 玲央名
- 所属:研究开发部 环境组
- 2020 年作为构建工程师入职 GAME FREAK
- 横向参与《宝可梦》系列开发的 CI/CD 构建和工具开发
- 目前主要负责开发基础设施的服务水平改善、安全强化和成本优化 自我介绍 / 髙山 玲央名
目次
- Z-A以前のCI/CD ビルド環境の紹介と課題
- WindowsコンテナとKubernetesを採用した理由
- 導入時の課題と対策 / 4. 導入成果・まとめ
目录
- Z-A 之前的 CI/CD 构建环境介绍与课题
- 采用 Windows 容器和 Kubernetes 的理由
- 导入时的课题与对策 / 4. 导入成果・总结
Z-A 之前的 CI/CD 构建环境介绍
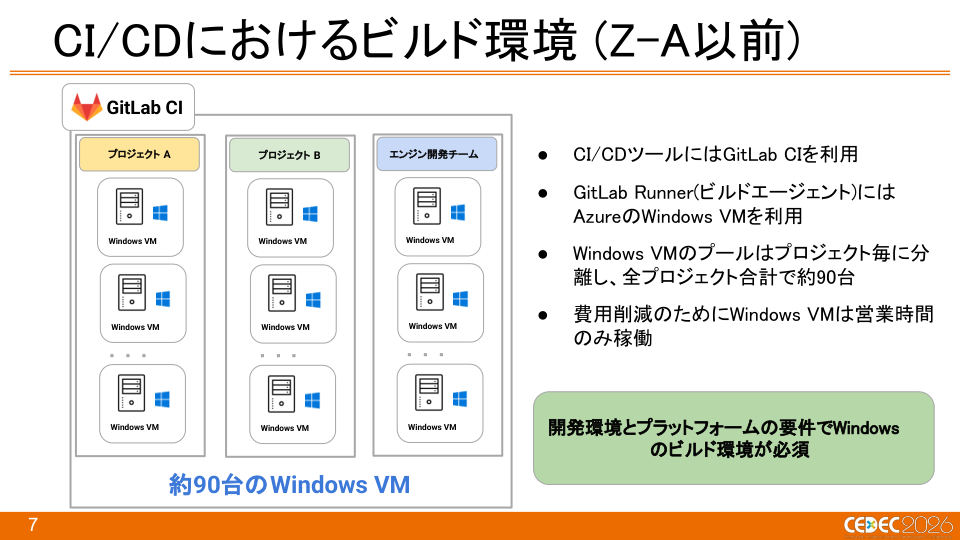
CI/CDにおけるビルド環境 (Z-A以前) GitLab CI
- CI/CDツールにはGitLab CIを利用
- GitLab Runner(ビルドエージェント)には AzureのWindows VMを利用
- Windows VMのプールはプロジェクト毎に分 離し、全プロジェクト合計で約90台
- 費用削減のためにWindows VMは営業時間 のみ稼働 / Windows VM / Windows VM / Windows VM ... プロジェクトA / Windows VM / Windows VM / Windows VM ... プロジェクトB / Windows VM / Windows VM / Windows VM ... エンジン開発チーム 約90台のWindows VM 開発環境とプラットフォームの要件でWindows のビルド環境が必須
CI/CD 中的构建环境(Z-A 之前) GitLab CI
- CI/CD 工具使用 GitLab CI
- GitLab Runner(构建代理)使用 Azure 的 Windows VM
- Windows VM 池按项目分离,所有项目合计约 90 台
- 为削减成本,Windows VM 仅在营业时间 运行 / Windows VM / Windows VM / Windows VM ... 项目 A / Windows VM / Windows VM / Windows VM ... 项目 B / Windows VM / Windows VM / Windows VM ... 引擎开发团队 约 90 台 Windows VM 由于开发环境和平台的要求,Windows 构建环境是必需的
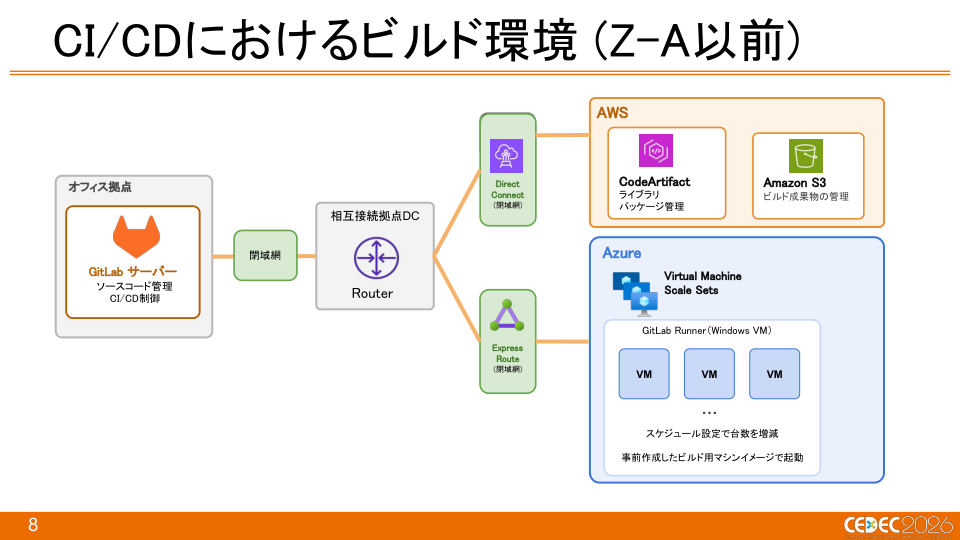
CI/CDにおけるビルド環境 (Z-A以前) Azure Virtual Machine Scale Sets GitLab Runner(Windows VM) VM / VM / VM / … / スケジュール設定で台数を増減 事前作成したビルド用マシンイメージで起動 AWS / CodeArtifact / ライブラリ / パッケージ管理 / Amazon S3 / ビルド成果物の管理 / GitLab サーバー / ソースコード管理 / CI/CD制御 / Express / Route / (閉域網) / Direct / Connect / (閉域網) / オフィス拠点 / 相互接続拠点DC / Router / 閉域網
CI/CD 中的构建环境(Z-A 之前) Azure Virtual Machine Scale Sets GitLab Runner(Windows VM) VM / VM / VM / … / 通过计划设置增减台数 使用预先创建的构建用机器镜像启动 AWS / CodeArtifact / 库 / 包管理 / Amazon S3 / 构建产物管理 / GitLab 服务器 / 源代码管理 / CI/CD 控制 / Express / Route / (封闭网络) / Direct / Connect / (封闭网络) / 办公室据点 / 互连据点 DC / Router / 封闭网络
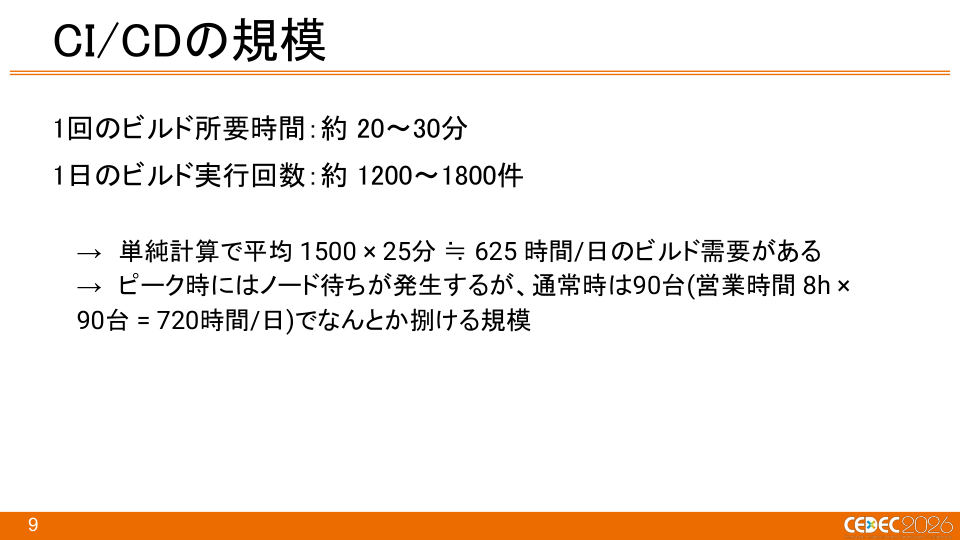
CI/CDの規模 1回のビルド所要時間:約 20〜30分 1日のビルド実行回数:約 1200~1800件 → 単純計算で平均 1500 × 25分 ≒ 625 時間/日のビルド需要がある → ピーク時にはノード待ちが発生するが、通常時は90台(営業時間 8h × 90台 = 720時間/日)でなんとか捌ける規模
CI/CD的规模 1次构建所需时间:约 20〜30分钟 1天的构建执行次数:约 1200~1800件 → 单纯计算,平均 1500 × 25分钟 ≒ 625 小时/天的构建需求 → 高峰时会出现节点等待,但平时90台(营业时间 8h × 90台 = 720小时/天)勉强能处理完的规模
Z-A以前CI/CD 构建环境的课题
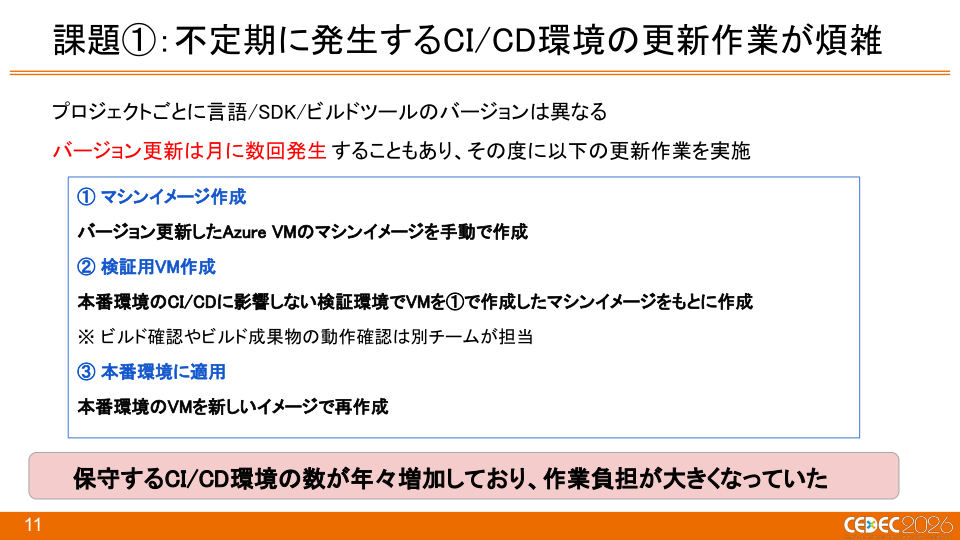
課題①:不定期に発生するCI/CD環境の更新作業が煩雑 プロジェクトごとに言語/SDK/ビルドツールのバージョンは異なる バージョン更新は月に数回発生することもあり、その度に以下の更新作業を実施 ① マシンイメージ作成 バージョン更新したAzure VMのマシンイメージを手動で作成 ② 検証用VM作成 本番環境のCI/CDに影響しない検証環境でVMを①で作成したマシンイメージをもとに作成 ※ ビルド確認やビルド成果物の動作確認は別チームが担当 ③ 本番環境に適用 本番環境のVMを新しいイメージで再作成 保守するCI/CD環境の数が年々増加しており、作業負担が大きくなっていた
课题①:不定期发生的CI/CD环境更新工作繁杂 每个项目的语言/SDK/构建工具版本不同 版本更新每月可能发生数次,每次都要进行以下更新工作 ① 创建机器镜像 手动创建更新了版本的Azure VM机器镜像 ② 创建验证用VM 在不会影响生产环境CI/CD的验证环境中,基于①创建的机器镜像创建VM ※ 构建确认和构建产物的动作确认由其他团队负责 ③ 应用到生产环境 用新镜像重新创建生产环境的VM 需要维护的CI/CD环境数量逐年增加,工作负担越来越大
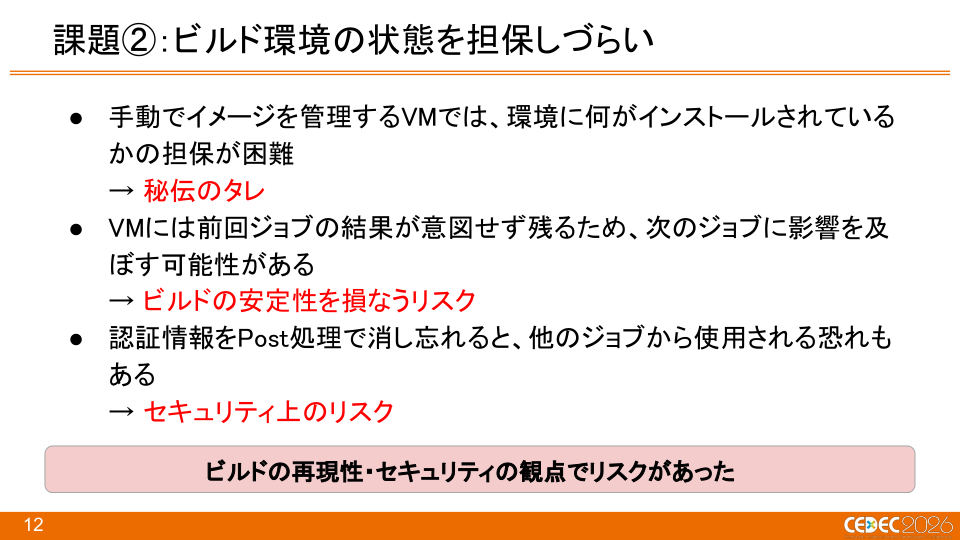
課題②:ビルド環境の状態を担保しづらい ビルドの再現性・セキュリティの観点でリスクがあった
- 手動でイメージを管理するVMでは、環境に何がインストールされている かの担保が困難 / → 秘伝のタレ
- VMには前回ジョブの結果が意図せず残るため、次のジョブに影響を及 ぼす可能性がある → ビルドの安定性を損なうリスク
- 認証情報をPost処理で消し忘れると、他のジョブから使用される恐れも ある / → セキュリティ上のリスク
课题②:难以保证构建环境的状态 从构建可复现性和安全性的角度来看存在风险
- 在手动管理镜像的VM中,难以保证环境中安装了什么 / → 秘传酱汁
- VM中会无意中残留上次作业的结果,可能影响下次作业 → 损害构建稳定性的风险
- 如果在Post处理中忘记删除认证信息,可能被其他作业使用 / → 安全上的风险
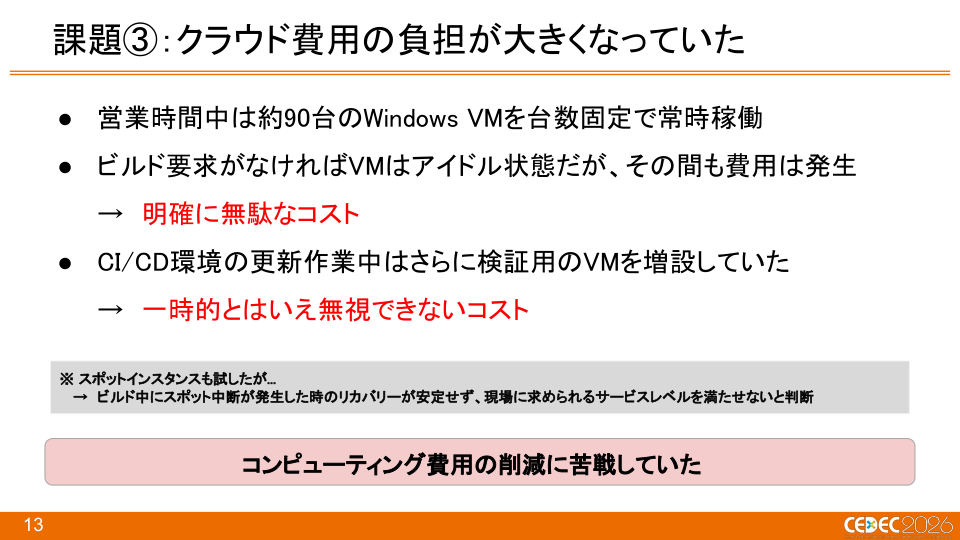
課題③:クラウド費用の負担が大きくなっていた
- 営業時間中は約90台のWindows VMを台数固定で常時稼働
- ビルド要求がなければVMはアイドル状態だが、その間も費用は発生 → 明確に無駄なコスト
- CI/CD環境の更新作業中はさらに検証用のVMを増設していた → 一時的とはいえ無視できないコスト コンピューティング費用の削減に苦戦していた ※ スポットインスタンスも試したが… → ビルド中にスポット中断が発生した時のリカバリーが安定せず、現場に求められるサービスレベルを満たせないと判断
课题③:云费用负担越来越大
- 营业时间内约90台Windows VM固定台数常时运行
- 没有构建请求时VM处于空闲状态,但期间仍会产生费用 → 明显是浪费的成本
- CI/CD环境更新作业期间还会增加验证用VM → 虽然是临时的,但也是不可忽视的成本 在削减计算费用上苦苦挣扎 ※ 也尝试过Spot实例,但是… → 构建中发生Spot中断时的恢复不稳定,判断无法满足现场要求的服务水平
課題④:CI/CD稼働時間の制限
- 費用を理由にCI/CD(Windows VM)の稼働は営業時間内に制限
- 土日や夜間に動かしたい場合は事前に相談が必要 → 開発のスピード感を損なう要因に
- 台数固定の運用では費用と開発者の利便性がトレードオフになる 費用の制約が開発者体験を損なう要因になっていた
课题④:CI/CD运行时间的限制
- 出于费用原因,CI/CD(Windows VM)的运行被限制在营业时间内
- 如果需要在周末或夜间运行,必须事先商量 → 成为损害开发速度感的因素
- 固定台数的运用中,费用和开发者便利性成为权衡关系 费用的制约成为损害开发者体验的因素
仮想マシンベースのビルド環境に限界を感じた 「CI/CDのビルド環境を柔軟に切り替えられないか?」 「ジョブ需要に応じてVMを自動スケールできないか?」 CI/CD環境のコンテナ(Kubernetes)化の検討を開始
感到基于虚拟机的构建环境已到极限 “能否灵活切换CI/CD的构建环境?” “能否根据作业需求自动扩展VM?” 开始探讨CI/CD环境的容器化(Kubernetes)
采用Windows容器和Kubernetes的理由
コンテナを採用した理由 - 1 / 2
- 1台のホストに複数バージョンを安全に同居できる
- SDK・コンパイラ・ビルドツールをジョブ単位で隔離
- VM内に複数バージョンを入れた時のツールチェイン競合や切替ミスが起きない
- Dockerfile = ビルド環境の定義
- ビルド環境に何がインストールされているかがコードで確認可能
- 課題で挙げた「環境の担保が困難」な状態をコードで解消できる
- 新旧バージョンの並行運用・ロールバックが容易
- 現環境に触れずに新環境を追加でき、切り戻しもタグを戻すだけで可能
- 過去ジョブの実行環境はイメージタグで追跡可能 「煩雑な環境更新作業」と「環境の担保」をコンテナ化で解消
采用容器的理由 - 1 / 2
- 可以在1台主机上安全地共存多个版本
- 按作业单位隔离 SDK、编译器、构建工具
- 不会出现将多个版本装入 VM 时发生的工具链冲突或切换失误
- Dockerfile = 构建环境的定义
- 可以通过代码确认构建环境中安装了哪些内容
- 可以用代码解决课题中提出的“难以保证环境”的状态
- 新旧版本的并行运行与回滚都很容易
- 可以在不触碰现有环境的情况下添加新环境,回退也只需还原标签即可
- 过去作业的执行环境可以通过镜像标签追踪 通过容器化解决“繁琐的环境更新作业”与“环境保证”
- クリーンな実行環境を担保しやすい
- コンテナはVMと比べて環境の生成/破棄が容易かつ迅速にできる
- ジョブ単位で環境を生成/破棄すれば課題で挙げた「前回ジョブの結果が次ジョブに 影響を及ぼす」と「認証情報の消し忘れ」のリスクがない コンテナを採用した理由 - 2 / 2 セキュリティ・安定性の課題をコンテナ化で改善
- 容易保证干净的运行环境
- 与 VM 相比,容器可以更容易且更迅速地创建/销毁环境
- 如果按作业单位创建/销毁环境,就不存在课题中提出的“上一次作业的结果影响下一次作业”以及“忘记删除认证信息”的风险 采用容器的理由 - 2 / 2 通过容器化改善安全性与稳定性课题
Kubernetesを採用した理由 ベンダー依存度が低い、ジョブ需要に応じたVMの自動スケールを実現
- ジョブ需要に応じたVMの自動スケールが可能
- 主流なCIツールはKubernetesと連携可能
- Jenkins/GitHub Actions/GitLab CI等
- ピーク時のキャパシティ確保とオフピーク時のコスト削減を両立
- ベンダーロックインを回避できる
- Kubernetes自体はOSSでセルフホスト可能
- 大手クラウドベンダーもマネージドサービスを提供
- 他マネージドサービスやオンプレミスへの移行時も、 Kubernetesのマニフェストファイルの大部分は使い回せる
采用 Kubernetes 的理由 降低供应商依赖度,实现根据作业需求自动扩缩 VM
- 可以根据作业需求自动扩缩 VM
- 主流 CI 工具可以与 Kubernetes 联动
- Jenkins/GitHub Actions/GitLab CI 等
- 兼顾高峰时的容量确保与低谷时的成本削减
- 可以避免供应商锁定
- Kubernetes 本身是 OSS,可以自托管
- 大型云供应商也提供托管服务
- 迁移到其他托管服务或本地环境时,Kubernetes 的 manifest 文件大部分都可以复用
- ゲームフリークではAWSとAzureをハイブリッドで運用
- それぞれのKubernetesマネージドサービスで検証を実施
- 結論、AWSとAzureどちらのサービスでもビルド性能を下げることなく、期 待通りの自動スケールが実現できることを確認
- しかし、導入する過程でいくつかの課題に直面
- コンテナイメージの取得時間
- Windowsコンテナネットワークの安定性
- 想定外のネットワーク費用の増加 導入検証を実施
- GAME FREAK 以混合方式运用 AWS 和 Azure
- 分别在各自的 Kubernetes 托管服务上进行验证
- 结论是,确认在 AWS 和 Azure 任一服务上都能在不降低构建性能的情况下实现预期的自动扩缩
- 但是,在导入过程中遇到了若干课题
- 容器镜像的获取时间
- Windows 容器网络的稳定性
- 超出预期的网络费用增加 实施了导入验证
导入时的课题与对策
容器镜像的获取时间
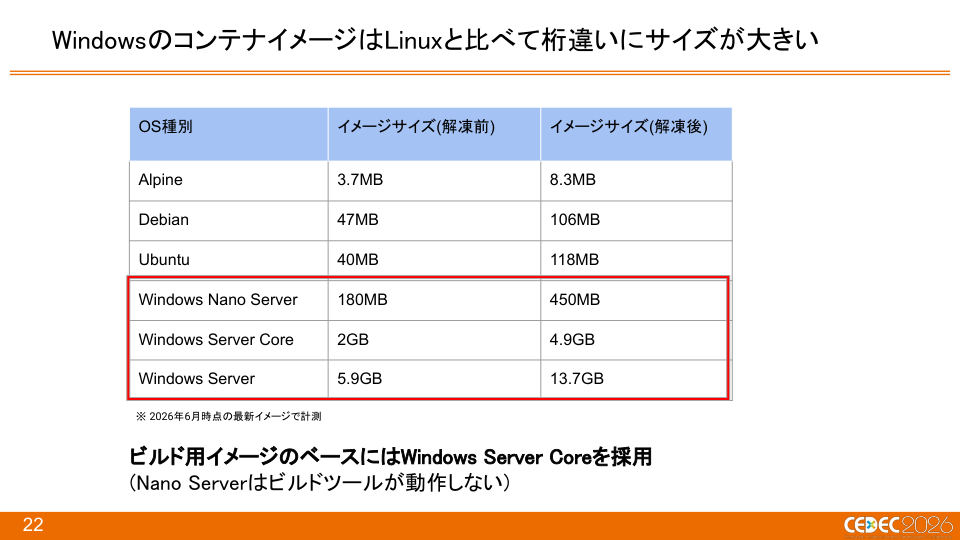
WindowsのコンテナイメージはLinuxと比べて桁違いにサイズが大きい OS種別 / イメージサイズ(解凍前) / イメージサイズ(解凍後) / Alpine / 3.7MB / 8.3MB / Debian / 47MB / 106MB / Ubuntu / 40MB / 118MB Windows Nano Server 180MB / 450MB Windows Server Core 2GB / 4.9GB / Windows Server / 5.9GB / 13.7GB ※ 2026年6月時点の最新イメージで計測 ビルド用イメージのベースにはWindows Server Coreを採用 (Nano Serverはビルドツールが動作しない)
Windows 容器镜像与 Linux 相比,大小相差悬殊 OS 类型 / 镜像大小(解压前) / 镜像大小(解压后) / Alpine / 3.7MB / 8.3MB / Debian / 47MB / 106MB / Ubuntu / 40MB / 118MB Windows Nano Server 180MB / 450MB Windows Server Core 2GB / 4.9GB / Windows Server / 5.9GB / 13.7GB ※ 以 2026 年 6 月时点的最新镜像进行测量 构建用镜像的基础采用 Windows Server Core (Nano Server 无法运行构建工具)
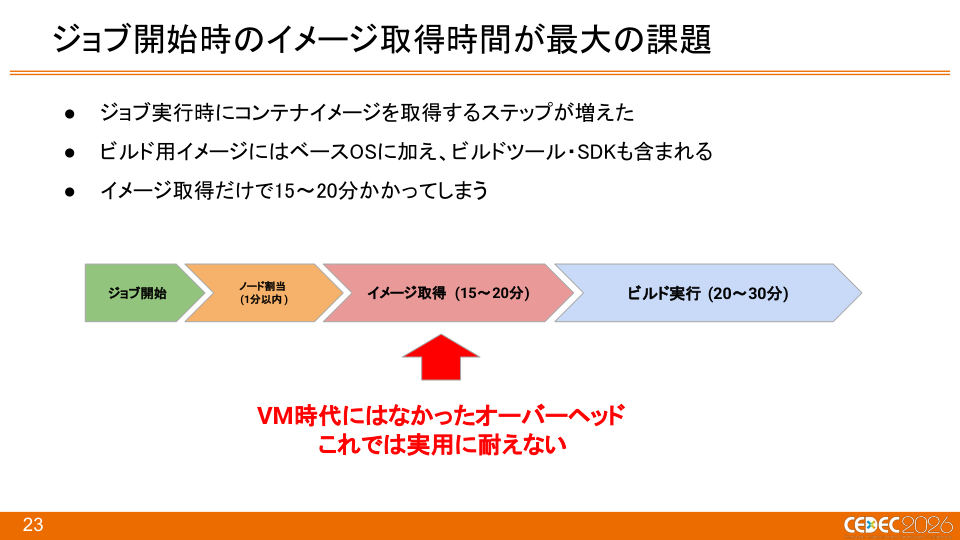
ジョブ開始時のイメージ取得時間が最大の課題
- ジョブ実行時にコンテナイメージを取得するステップが増えた
- ビルド用イメージにはベースOSに加え、ビルドツール・SDKも含まれる
- イメージ取得だけで15〜20分かかってしまう ジョブ開始 / ノード割当 / (1分以内) イメージ取得 (15~20分) ビルド実行 (20~30分) VM時代にはなかったオーバーヘッド これでは実用に耐えない
作业开始时的镜像获取时间是最大的课题
- 作业执行时增加了获取容器镜像的步骤
- 构建用镜像除了基础 OS 之外,还包含构建工具、SDK
- 仅镜像获取就要花费 15〜20 分钟 作业开始 / 节点分配 / (1分钟以内) 镜像获取 (15〜20分钟) 构建执行 (20〜30分钟) 这是 VM 时代没有的开销 这样无法承受实际使用
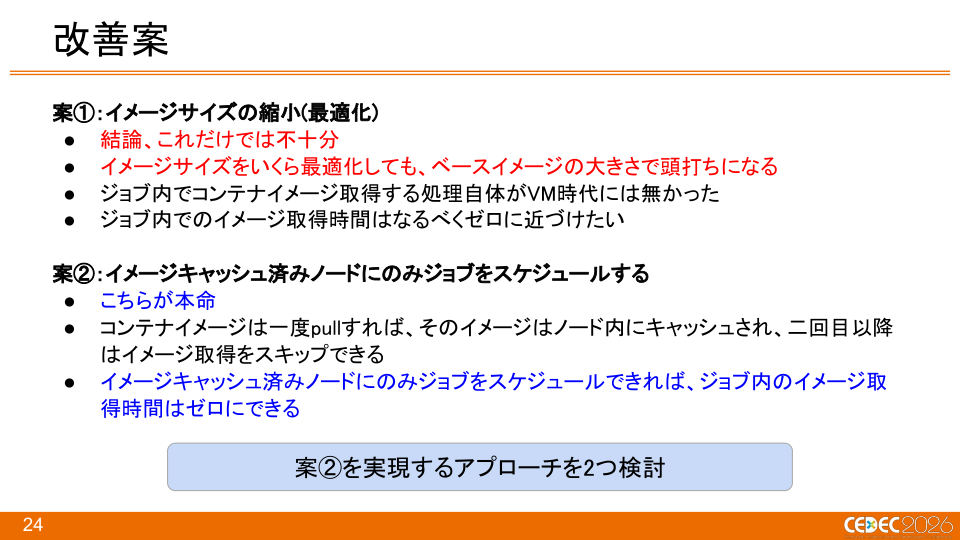
改善案 案①:イメージサイズの縮小(最適化)
- 結論、これだけでは不十分
- イメージサイズをいくら最適化しても、ベースイメージの大きさで頭打ちになる
- ジョブ内でコンテナイメージ取得する処理自体がVM時代には無かった
- ジョブ内でのイメージ取得時間はなるべくゼロに近づけたい 案②:イメージキャッシュ済みノードにのみジョブをスケジュールする
- こちらが本命
- コンテナイメージは一度pullすれば、そのイメージはノード内にキャッシュされ、二回目以降 はイメージ取得をスキップできる
- イメージキャッシュ済みノードにのみジョブをスケジュールできれば、ジョブ内のイメージ取 得時間はゼロにできる 案②を実現するアプローチを2つ検討
改善方案 方案①:缩小镜像大小(优化)
- 结论:仅靠这一点并不充分
- 无论怎样优化镜像大小,都会受限于基础镜像的大小
- 在作业内获取容器镜像的处理本身在 VM 时代是不存在的
- 希望尽量将作业内的镜像获取时间趋近于零 方案②:仅将作业调度到已缓存镜像的节点上
- 这才是根本方案
- 容器镜像一旦 pull 过一次,该镜像就会被缓存在节点内,第二次以后 即可跳过镜像获取
- 如果能够仅将作业调度到已缓存镜像的节点上,作业内的镜像获取时间就可以降为零 探讨了两种实现方案②的方法
イメージキャッシュ済みノードにのみ ジョブをスケジュールする方法 アプローチ① - KubernetesのDaemonSetとTaintの活用
仅将作业调度到已缓存镜像的节点上的方法 方案① - 利用 Kubernetes 的 DaemonSet 与 Taint
登場するKubernetes用語
- Pod
- DaemonSet
- Taint/Toleration この後の説明に登場するKubernetesの用語を3つ紹介します
涉及的 Kubernetes 术语
- Pod
- DaemonSet
- Taint/Toleration 介绍后续说明中会出现的 3 个 Kubernetes 术语
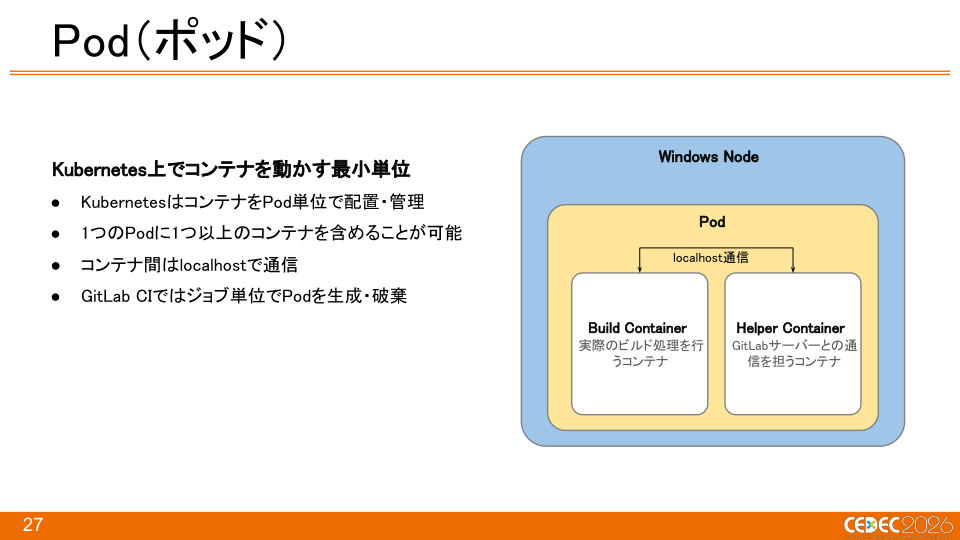
Pod(ポッド) / Windows Node / Pod Build Container 実際のビルド処理を行 / うコンテナ Helper Container GitLabサーバーとの通 / 信を担うコンテナ Kubernetes上でコンテナを動かす最小単位
- KubernetesはコンテナをPod単位で配置・管理
- 1つのPodに1つ以上のコンテナを含めることが可能
- コンテナ間はlocalhostで通信
- GitLab CIではジョブ単位でPodを生成・破棄 localhost通信
Pod(Pod) / Windows Node / Pod Build Container 实际执行构建处理的容器 Helper Container 负责与 GitLab 服务器通信的容器 Kubernetes 上运行容器的最小单位
- Kubernetes 以 Pod 为单位进行容器的配置与管理
- 1 个 Pod 可以包含 1 个以上的容器
- 容器之间通过 localhost 通信
- 在 GitLab CI 中,按作业单位生成与销毁 Pod localhost 通信
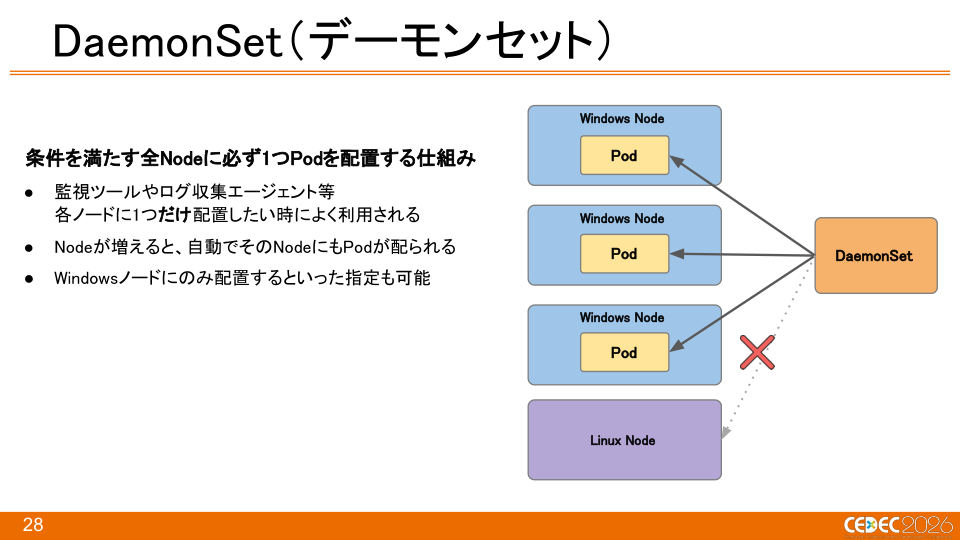
DaemonSet(デーモンセット) 条件を満たす全Nodeに必ず1つPodを配置する仕組み
- 監視ツールやログ収集エージェント等 各ノードに1つだけ配置したい時によく利用される
- Nodeが増えると、自動でそのNodeにもPodが配られる
- Windowsノードにのみ配置するといった指定も可能 DaemonSet / Windows Node / Windows Node / Windows Node / Linux Node / Pod / Pod / Pod
DaemonSet(DaemonSet) 一种在满足条件的全部 Node 上必定配置 1 个 Pod 的机制
- 常用于希望在每个节点上只配置一个监控工具或日志收集代理等的情况
- 当 Node 增加时,会自动向该 Node 也分发 Pod
- 也可以指定仅配置到 Windows 节点上 DaemonSet / Windows Node / Windows Node / Windows Node / Linux Node / Pod / Pod / Pod
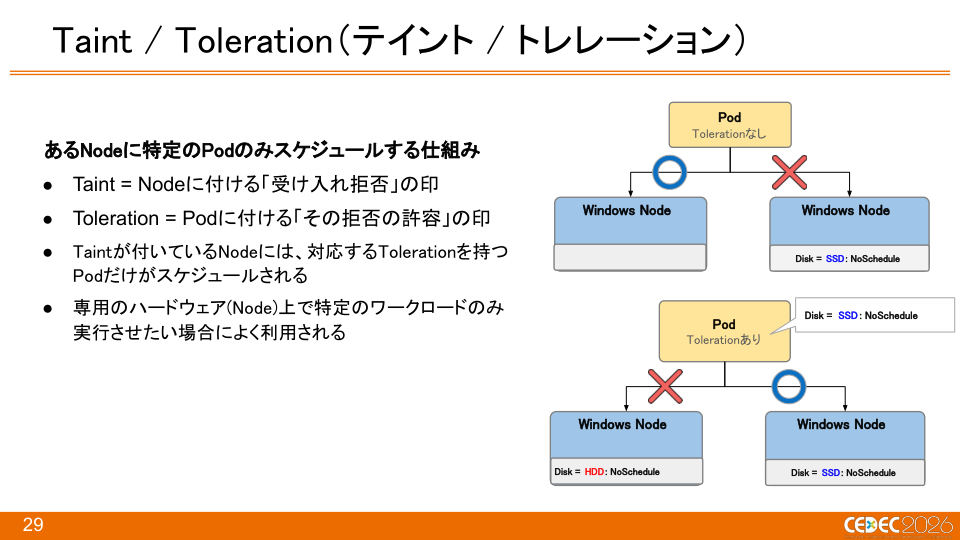
あるNodeに特定のPodのみスケジュールする仕組み
- Taint = Nodeに付ける「受け入れ拒否」の印
- Toleration = Podに付ける「その拒否の許容」の印
- Taintが付いているNodeには、対応するTolerationを持つ Podだけがスケジュールされる
- 専用のハードウェア(Node)上で特定のワークロードのみ 実行させたい場合によく利用される Taint / Toleration(テイント / トレレーション) Windows Node Disk = SSD: NoSchedule Pod / Tolerationあり / Windows Node / Windows Node Disk = SSD: NoSchedule Pod / Tolerationなし / Windows Node Disk = SSD : NoSchedule Disk = HDD: NoSchedule
一种仅将特定 Pod 调度到某个 Node 上的机制
- Taint = 附加到 Node 上的“拒绝接收”标记
- Toleration = 附加到 Pod 上的“容许该拒绝”标记
- 带有 Taint 的 Node 上,只有持有对应 Toleration 的 Pod 才会被调度
- 常用于希望仅在专用硬件(Node)上运行特定工作负载的情况 Taint / Toleration(Taint / Toleration) Windows Node Disk = SSD: NoSchedule Pod / 有 Toleration / Windows Node / Windows Node Disk = SSD: NoSchedule Pod / 无 Toleration / Windows Node Disk = SSD : NoSchedule Disk = HDD: NoSchedule
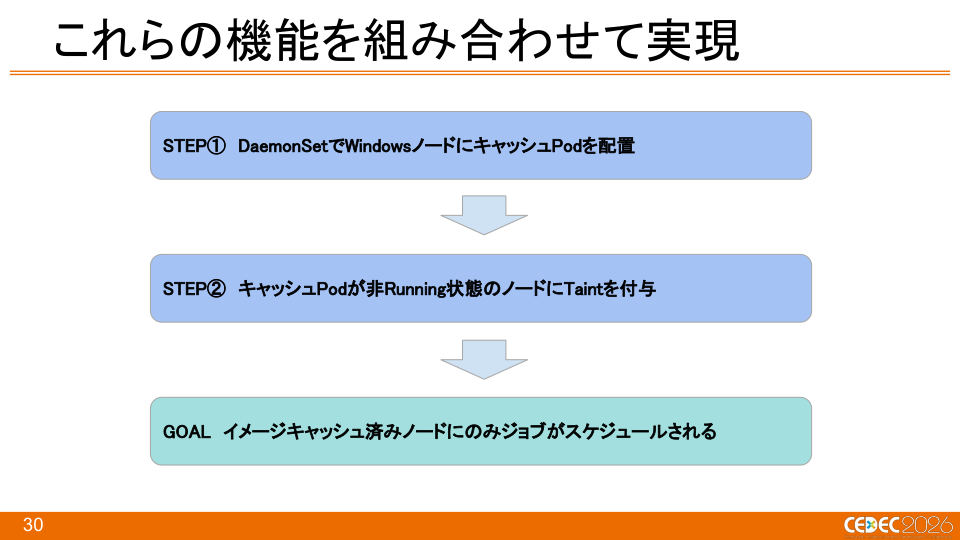
これらの機能を組み合わせて実現 STEP① DaemonSetでWindowsノードにキャッシュPodを配置 STEP② キャッシュPodが非Running状態のノードにTaintを付与 GOAL イメージキャッシュ済みノードにのみジョブがスケジュールされる
组合这些功能来实现 STEP① 用 DaemonSet 将缓存 Pod 配置到 Windows 节点上 STEP② 对缓存 Pod 处于非 Running 状态的节点赋予 Taint GOAL 作业仅被调度到已缓存镜像的节点上
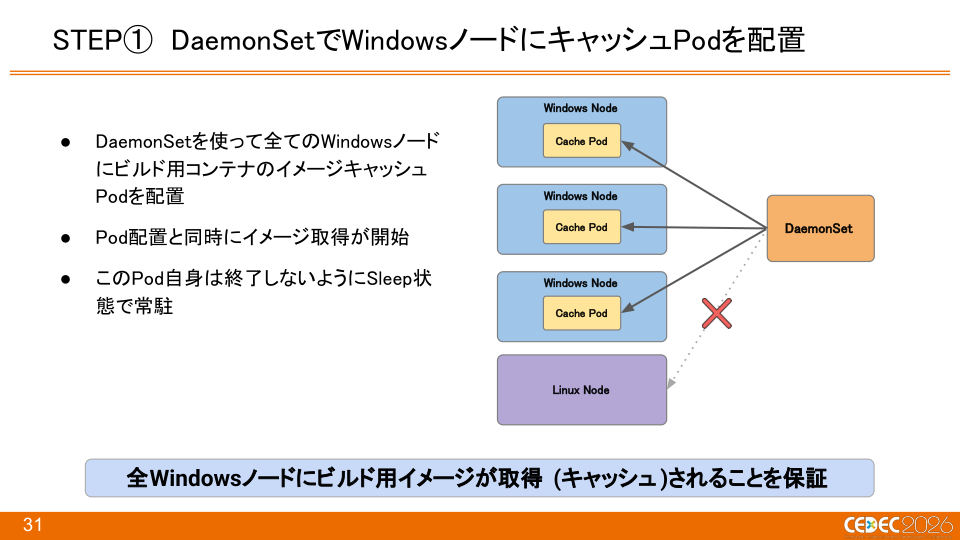
- DaemonSetを使って全てのWindowsノード にビルド用コンテナのイメージキャッシュ Podを配置
- Pod配置と同時にイメージ取得が開始
- このPod自身は終了しないようにSleep状 態で常駐 STEP① DaemonSetでWindowsノードにキャッシュPodを配置 全Windowsノードにビルド用イメージが取得(キャッシュ)されることを保証 DaemonSet / Windows Node / Windows Node / Windows Node / Linux Node / Cache Pod / Cache Pod / Cache Pod
- 使用 DaemonSet 将构建用容器镜像的缓存 Pod 配置到所有 Windows 节点上
- 在配置 Pod 的同时开始获取镜像
- 该 Pod 自身不会结束,而是以 Sleep 状态常驻 STEP① 用 DaemonSet 将缓存 Pod 配置到 Windows 节点上 保证构建用镜像被获取(缓存)到所有 Windows 节点上 DaemonSet / Windows Node / Windows Node / Windows Node / Linux Node / Cache Pod / Cache Pod / Cache Pod
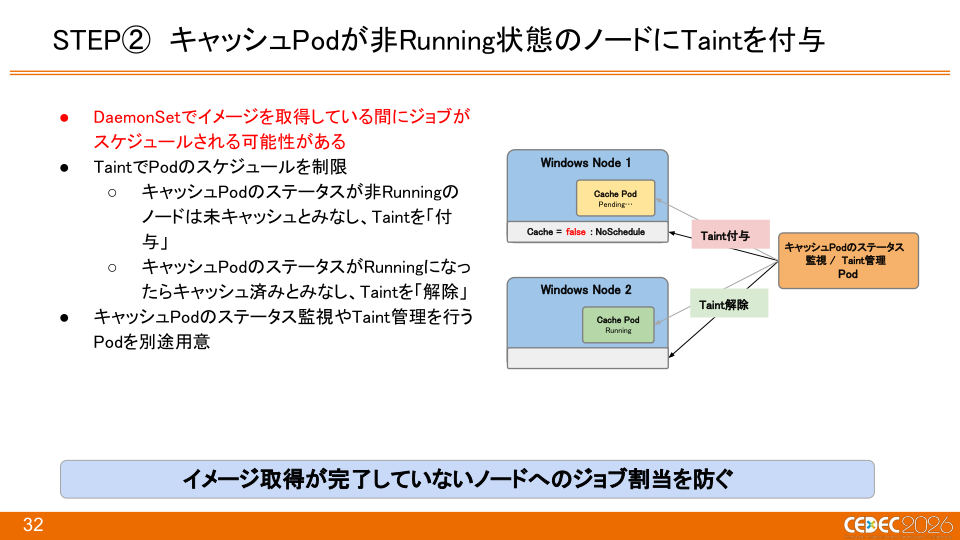
- DaemonSetでイメージを取得している間にジョブが スケジュールされる可能性がある
- TaintでPodのスケジュールを制限
- キャッシュPodのステータスが非Runningの ノードは未キャッシュとみなし、Taintを「付 与」
- キャッシュPodのステータスがRunningになっ たらキャッシュ済みとみなし、Taintを「解除」
- キャッシュPodのステータス監視やTaint管理を行う Podを別途用意 STEP② キャッシュPodが非Running状態のノードにTaintを付与 Windows Node 1 / Windows Node 2 / Cache Pod / Pending… / Cache Pod / Running / キャッシュPodのステータス / 監視 / Taint管理 / Pod イメージ取得が完了していないノードへのジョブ割当を防ぐ Cache = false : NoSchedule Taint解除 / Taint付与
- 在 DaemonSet 拉取镜像期间,作业可能会被调度
- 通过 Taint 限制 Pod 的调度
- 缓存 Pod 状态为非 Running 的节点视为未缓存,并「附加」Taint
- 缓存 Pod 状态变为 Running 后视为已缓存,并「解除」Taint
- 另行准备用于监控缓存 Pod 状态及管理 Taint 的 Pod STEP② 对缓存 Pod 处于非 Running 状态的节点附加 Taint Windows Node 1 / Windows Node 2 / Cache Pod / Pending… / Cache Pod / Running / 缓存 Pod 的状态 / 监控 / Taint 管理 / Pod 防止将作业分配到镜像拉取尚未完成的节点 Cache = false : NoSchedule Taint 解除 / Taint 附加
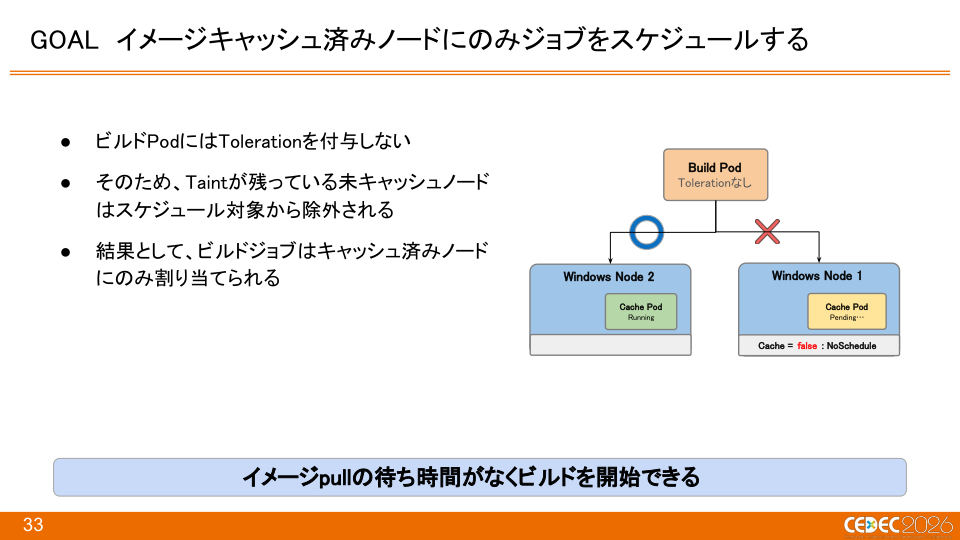
GOAL イメージキャッシュ済みノードにのみジョブをスケジュールする Build Pod / Tolerationなし / Windows Node 1 / Windows Node 2 / Cache Pod / Pending… / Cache Pod / Running Cache = false : NoSchedule イメージpullの待ち時間がなくビルドを開始できる
- ビルドPodにはTolerationを付与しない
- そのため、Taintが残っている未キャッシュノード はスケジュール対象から除外される
- 結果として、ビルドジョブはキャッシュ済みノード にのみ割り当てられる
GOAL 仅将作业调度到镜像已缓存的节点 Build Pod / 无 Toleration / Windows Node 1 / Windows Node 2 / Cache Pod / Pending… / Cache Pod / Running Cache = false : NoSchedule 无需等待镜像 pull 即可开始构建
- 构建 Pod 不附加 Toleration
- 因此,仍保留 Taint 的未缓存节点会被排除在调度对象之外
- 结果,构建作业只会被分配到已缓存的节点
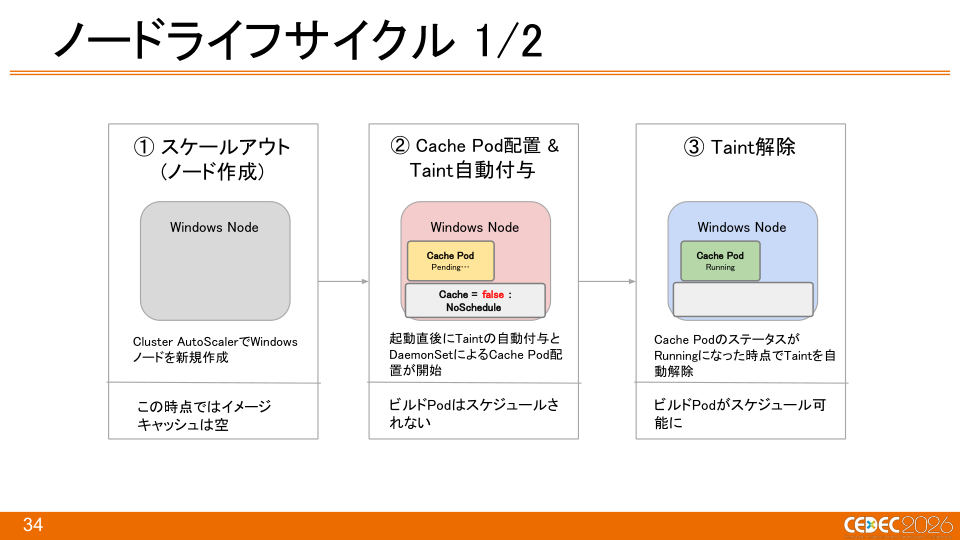
ノードライフサイクル 1/2 / ① スケールアウト / (ノード作成) / Windows Node Cluster AutoScalerでWindows ノードを新規作成 / この時点ではイメージ / キャッシュは空 ② Cache Pod配置 & Taint自動付与 / Windows Node 起動直後にTaintの自動付与と DaemonSetによるCache Pod配 置が開始 / ビルドPodはスケジュールさ / れない / ③ Taint解除 / Windows Node Cache Podのステータスが Runningになった時点でTaintを自 動解除 / ビルドPodがスケジュール可 / 能に Cache = false : NoSchedule / Cache Pod / Pending… / Cache Pod / Running
节点生命周期 1/2 / ① 扩容 / (创建节点) / Windows Node 通过 Cluster AutoScaler 新建 Windows 节点 / 此时镜像缓存为空 ② 配置 Cache Pod & 自动附加 Taint / Windows Node 节点启动后立即开始自动附加 Taint,并通过 DaemonSet 配置 Cache Pod / 构建 Pod 不会被调度 / ③ 解除 Taint / Windows Node 当 Cache Pod 状态变为 Running 时自动解除 Taint / 构建 Pod 变为可调度 Cache = false : NoSchedule / Cache Pod / Pending… / Cache Pod / Running
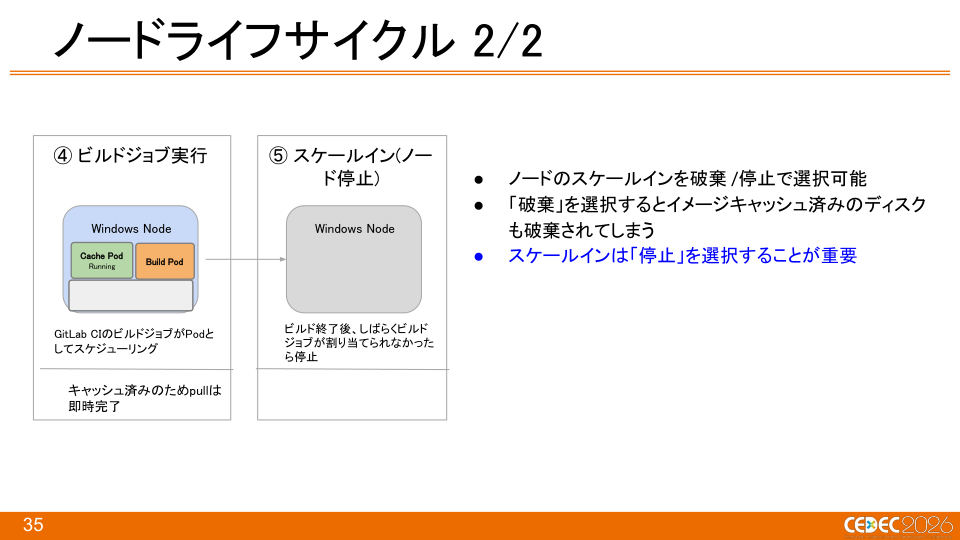
ノードライフサイクル 2/2 / ④ ビルドジョブ実行 GitLab CIのビルドジョブがPodと してスケジューリング キャッシュ済みのためpullは 即時完了 / ⑤ スケールイン(ノー / ド停止) / Windows Node / ビルド終了後、しばらくビルド / ジョブが割り当てられなかった / ら停止 / Windows Node
- ノードのスケールインを破棄/停止で選択可能
- 「破棄」を選択するとイメージキャッシュ済みのディスク も破棄されてしまう
- スケールインは「停止」を選択することが重要 Cache Pod / Running / Build Pod
节点生命周期 2/2 / ④ 执行构建作业 GitLab CI 的构建作业作为 Pod 被调度 由于已缓存,pull 可立即完成 / ⑤ 缩容(停止节点) / Windows Node / 构建结束后,若一段时间内没有分配构建作业则停止 / Windows Node
- 节点的缩容可选择「销毁」或「停止」
- 若选择「销毁」,镜像已缓存的磁盘也会被销毁
- 缩容时选择「停止」很重要 Cache Pod / Running / Build Pod
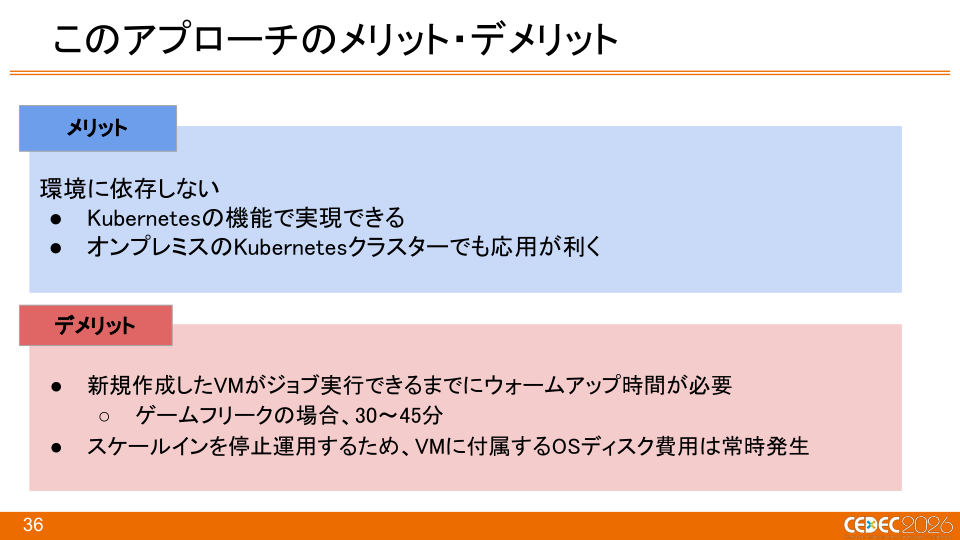
このアプローチのメリット・デメリット 環境に依存しない
- Kubernetesの機能で実現できる
- オンプレミスのKubernetesクラスターでも応用が利く
- 新規作成したVMがジョブ実行できるまでにウォームアップ時間が必要
- ゲームフリークの場合、30~45分
- スケールインを停止運用するため、VMに付属するOSディスク費用は常時発生 メリット / デメリット
该方法的优点与缺点 不依赖环境
- 可通过 Kubernetes 的功能实现
- 在本地部署的 Kubernetes 集群中也能应用
- 新建的 VM 到能够执行作业需要预热时间
- 在 GAME FREAK 的情况下为 30~45 分钟
- 由于缩容采用停止运用,VM 附带的 OS 磁盘费用会持续产生 优点 / 缺点
イメージキャッシュ済みノードにのみ ジョブをスケジュールする方法 アプローチ② - カスタムマシンイメージの活用
仅将作业调度到镜像已缓存的节点的方法 方法② - 利用自定义机器镜像
イメージpull マシンイメージをカスタマイズする
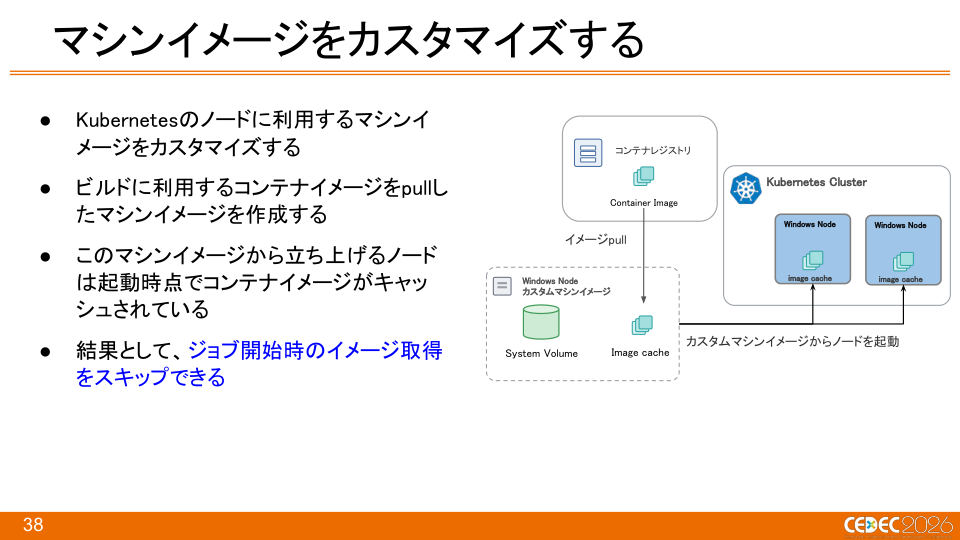
- Kubernetesのノードに利用するマシンイ メージをカスタマイズする
- ビルドに利用するコンテナイメージをpullし たマシンイメージを作成する
- このマシンイメージから立ち上げるノード は起動時点でコンテナイメージがキャッ シュされている
- 結果として、ジョブ開始時のイメージ取得 をスキップできる / コンテナレジストリ Container Image Windows Node / カスタムマシンイメージ / System Volume / Image cache カスタムマシンイメージからノードを起動 Kubernetes Cluster Windows Node / image cache / Windows Node / image cache
镜像 pull 自定义机器镜像
- 自定义用于 Kubernetes 节点的机器镜像
- 创建已 pull 构建所用容器镜像的机器镜像
- 从该机器镜像启动的节点在启动时已缓存容器镜像
- 结果,可跳过作业开始时的镜像拉取 / 容器镜像仓库 Container Image Windows Node / 自定义机器镜像 / System Volume / Image cache 从自定义机器镜像启动节点 Kubernetes Cluster Windows Node / image cache / Windows Node / image cache
このアプローチのメリット・デメリット
- VM作成後のウォームアップ時間がなく、瞬時にスケールできる
- DaemonSet + Taintのような独自のKubernetesリソースの管理が不要
- カスタムマシンイメージに対応しているベンダーが限定 (※2026年6月時点)
- AWS : 利用可
- Azure : 未対応
- GCP : 未対応
- カスタムマシンイメージの管理が必要 メリット / デメリット
该方法的优点与缺点
- 没有 VM 创建后的预热时间,可瞬间扩容
- 无需管理像 DaemonSet + Taint 这样的自定义 Kubernetes 资源
- 支持自定义机器镜像的供应商有限(※截至 2026 年 6 月)
- AWS:可用
- Azure:未支持
- GCP:未支持
- 需要管理自定义机器镜像 优点 / 缺点
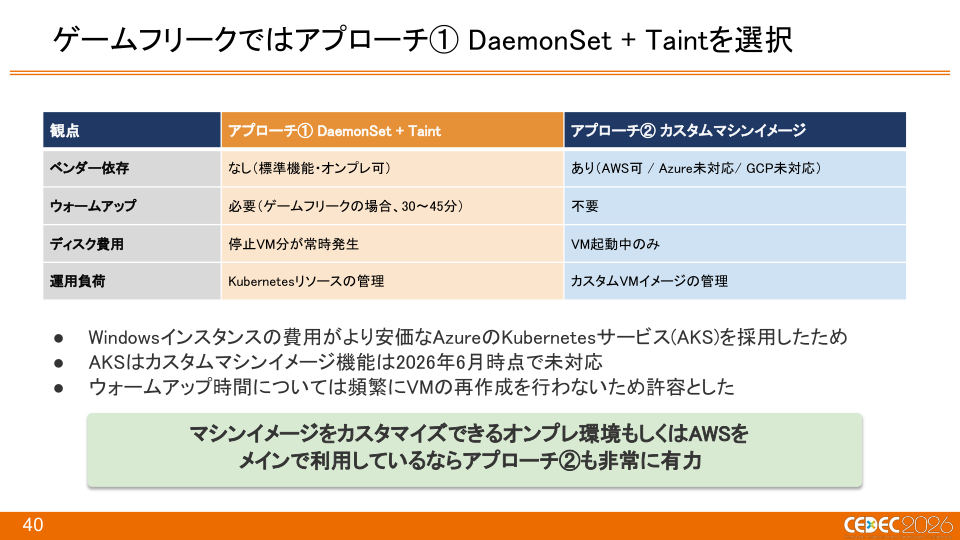
ゲームフリークではアプローチ① DaemonSet + Taintを選択 観点 アプローチ① DaemonSet + Taint アプローチ② カスタムマシンイメージ ベンダー依存 / なし(標準機能・オンプレ可) あり(AWS可 / Azure未対応/ GCP未対応) ウォームアップ 必要(ゲームフリークの場合、30〜45分) 不要 / ディスク費用 / 停止VM分が常時発生 / VM起動中のみ / 運用負荷 Kubernetesリソースの管理 カスタムVMイメージの管理 マシンイメージをカスタマイズできるオンプレ環境もしくはAWSを メインで利用しているならアプローチ②も非常に有力
- Windowsインスタンスの費用がより安価なAzureのKubernetesサービス(AKS)を採用したため
- AKSはカスタムマシンイメージ機能は2026年6月時点で未対応
- ウォームアップ時間については頻繁にVMの再作成を行わないため許容とした
GAME FREAK 选择了方案① DaemonSet + Taint
| 观点 | 方案① DaemonSet + Taint | 方案② 自定义机器镜像 |
|---|---|---|
| 供应商依赖 | 无(标准功能・可本地部署) | 有(AWS 可用 / Azure 不支持 / GCP 不支持) |
| 预热 | 需要(GAME FREAK 的情况下,30〜45 分钟) | 不需要 |
| 磁盘费用 | 停止 VM 部分持续产生 | 仅 VM 启动期间产生 |
| 运维负担 | 管理 Kubernetes 资源 | 管理自定义 VM 镜像 |
如果主要使用可自定义机器镜像的本地环境或 AWS,方案②也非常有潜力
- 因为采用了 Windows 实例费用更便宜的 Azure 的 Kubernetes 服务(AKS)
- AKS 在 2026 年 6 月时点尚未支持自定义机器镜像功能
- 关于预热时间,由于不会频繁重建 VM,因此视为可接受
Windows 容器网络的稳定性
実際に発生した問題:GitLabサーバーのDNS名前解決に失敗
- 特定ノードでGitLabサーバーのDNS名前解決に失敗する事象が稀に発生
- GitLab Runner ⇔ GitLab間の通信ができない
- そのノードに割り当てられたジョブは確定で失敗する
- ノードを再起動すると正常化する 発生頻度は低いものの不定期に発生し、再現条件の特定が難しかった
实际发生的问题:GitLab 服务器的 DNS 名称解析失败
- 特定节点上偶尔发生 GitLab 服务器的 DNS 名称解析失败
- GitLab Runner ⇔ GitLab 之间无法通信
- 分配给该节点的作业必定失败
- 重启节点后恢复正常
虽然发生频率低,但不定期发生,难以确定复现条件
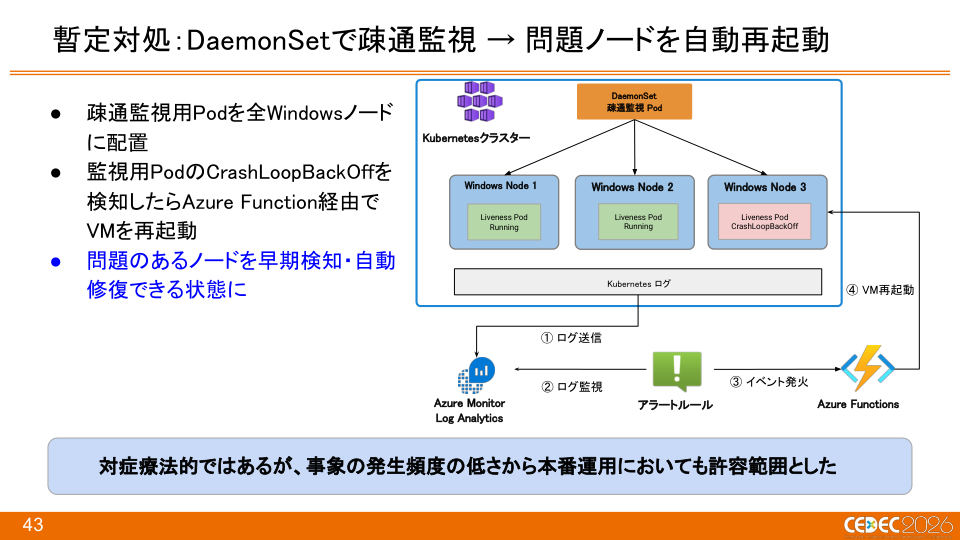
暫定対処:DaemonSetで疎通監視 → 問題ノードを自動再起動 DaemonSet / 疎通監視 Pod 対症療法的ではあるが、事象の発生頻度の低さから本番運用においても許容範囲とした Windows Node 1 / Liveness Pod / Running / Windows Node 2 / Liveness Pod / Running / Windows Node 3 / Liveness Pod CrashLoopBackOff ④ VM再起動
- 疎通監視用Podを全Windowsノード に配置
- 監視用PodのCrashLoopBackOffを 検知したらAzure Function経由で VMを再起動
- 問題のあるノードを早期検知・自動 修復できる状態に Kubernetesクラスター Azure Monitor / Log Analytics Azure Functions アラートルール / Kubernetes ログ / ③ イベント発火 / ② ログ監視 / ① ログ送信
临时对策:通过 DaemonSet 进行连通性监控 → 自动重启问题节点 DaemonSet / 连通性监控 Pod
虽然是治标不治本,但鉴于事件发生频率低,在生产运用中也视为可接受范围
Windows Node 1 / Liveness Pod / Running / Windows Node 2 / Liveness Pod / Running / Windows Node 3 / Liveness Pod CrashLoopBackOff ④ VM 重启
- 在所有 Windows 节点上部署连通性监控用 Pod
- 检测到监控用 Pod 的 CrashLoopBackOff 后,通过 Azure Function 重启 VM
- 达到能够早期检测并自动修复问题节点的状态
Kubernetes 集群 Azure Monitor / Log Analytics Azure Functions 警报规则 / Kubernetes 日志 / ③ 事件触发 / ② 日志监控 / ① 日志发送
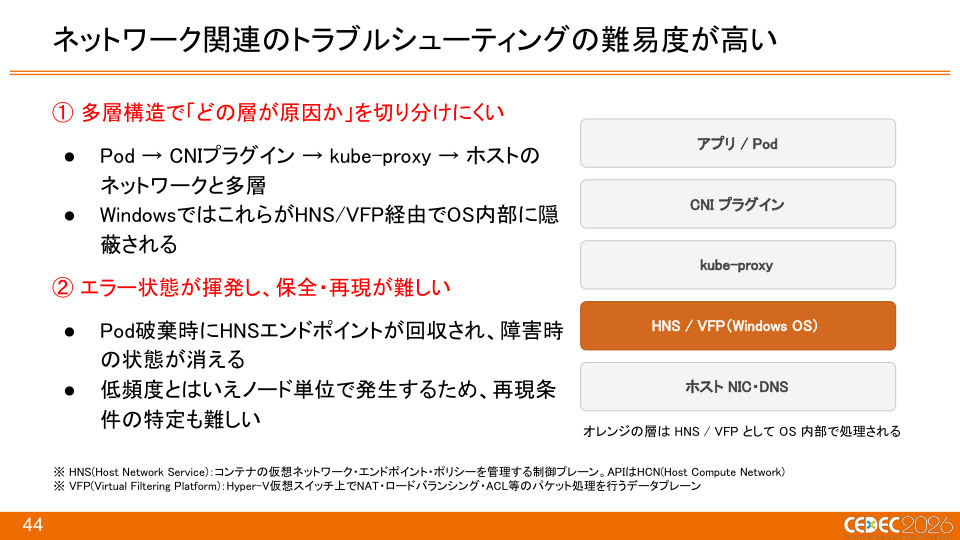
① 多層構造で「どの層が原因か」を切り分けにくい
- Pod → CNIプラグイン → kube-proxy → ホストの ネットワークと多層
- WindowsではこれらがHNS/VFP経由でOS内部に隠 蔽される ② エラー状態が揮発し、保全・再現が難しい
- Pod破棄時にHNSエンドポイントが回収され、障害時 の状態が消える
- 低頻度とはいえノード単位で発生するため、再現条 件の特定も難しい ネットワーク関連のトラブルシューティングの難易度が高い アプリ / Pod / CNI プラグイン / kube-proxy HNS / VFP(Windows OS) ホスト NIC・DNS オレンジの層は HNS / VFP として OS 内部で処理される ※ HNS(Host Network Service):コンテナの仮想ネットワーク・エンドポイント・ポリシーを管理する制御プレーン。APIはHCN(Host Compute Network) ※ VFP(Virtual Filtering Platform):Hyper-V仮想スイッチ上でNAT・ロードバランシング・ACL等のパケット処理を行うデータプレーン
① 多层结构导致难以判断“哪一层是原因”
- Pod → CNI 插件 → kube-proxy → 主机的网络,多层结构
- 在 Windows 中,这些通过 HNS/VFP 被隐藏在 OS 内部 ② 错误状态易失,难以保存和复现
- Pod 销毁时 HNS 端点被回收,故障时的状态消失
- 虽然频率低,但以节点为单位发生,因此也难以确定复现条件
网络相关故障排查难度高
应用 / Pod / CNI 插件 / kube-proxy HNS / VFP(Windows OS) 主机 NIC・DNS 橙色层作为 HNS / VFP 在 OS 内部处理 ※ HNS(Host Network Service):管理容器虚拟网络、端点、策略的控制平面。API 为 HCN(Host Compute Network) ※ VFP(Virtual Filtering Platform):在 Hyper-V 虚拟交换机上进行 NAT、负载均衡、ACL 等数据包处理的数据平面
- kube-state-metrics・cAdvisorによる監視は行っていたが、これだけでは不十 分
- 問題発生時のネットワーク調査を可能な状態にする
- windows_exporter(HostProcessコンテナ)によってHNS(ネットワーク)と HCS(コンテナ実行)の状態を時系列で保存
- CrashLoopをトリガーにネットワーク診断ツールを自動実行 → 結果を永 続ストレージに自動保存 今後の取り組み:モニタリング環境の強化 ※ ネットワーク診断ツールはMicrosoft SDN GitHubリポジトリで公開されているものを使用。URLは 本スライドの最後(付録)に記載
- 虽然进行了 kube-state-metrics・cAdvisor 的监控,但仅此并不充分
- 使问题发生时的网络调查成为可能
- 通过 windows_exporter(HostProcess 容器) 将 HNS(网络) 和 HCS(容器执行) 的状态按时间序列保存
- 以 CrashLoop 为触发自动执行网络诊断工具 → 结果自动保存到持久存储
今后的举措:强化监控环境 ※ 网络诊断工具使用 Microsoft SDN GitHub 仓库中公开的工具。URL 记载于本幻灯片最后(附录)
意料之外的网络费用增加
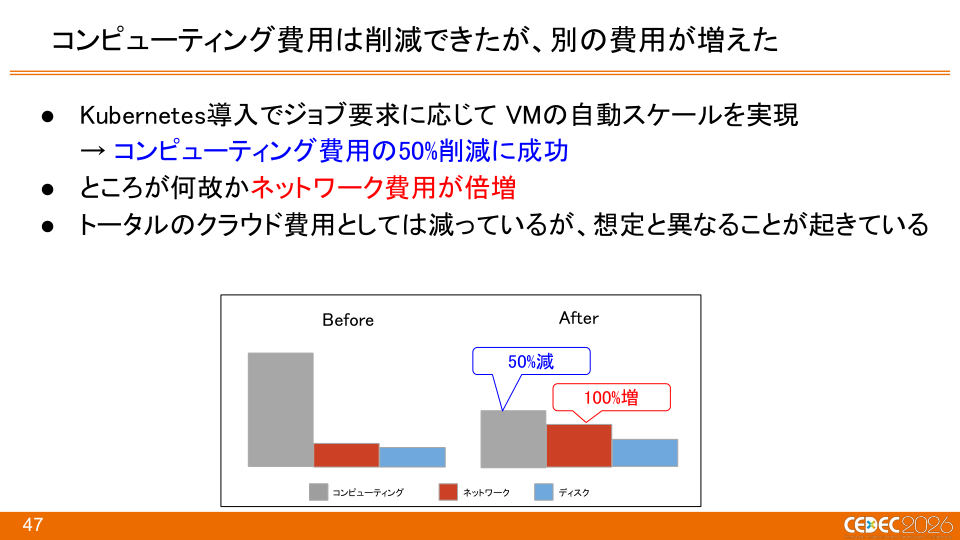
コンピューティング費用は削減できたが、別の費用が増えた
- Kubernetes導入でジョブ要求に応じて VMの自動スケールを実現 → コンピューティング費用の50%削減に成功
- ところが何故かネットワーク費用が倍増
- トータルのクラウド費用としては減っているが、想定と異なることが起きている コンピューティング / ネットワーク / ディスク / Before / After / 50%減 / 100%増
计算费用得以削减,但其他费用增加了
- 通过引入 Kubernetes,实现了根据作业需求自动扩展 VM → 成功削减了 50% 的计算费用
- 然而不知为何网络费用翻倍
- 虽然云费用总额减少了,但发生了与预期不同的事情
计算 / 网络 / 磁盘 / Before / After / 减少 50% / 增加 100%
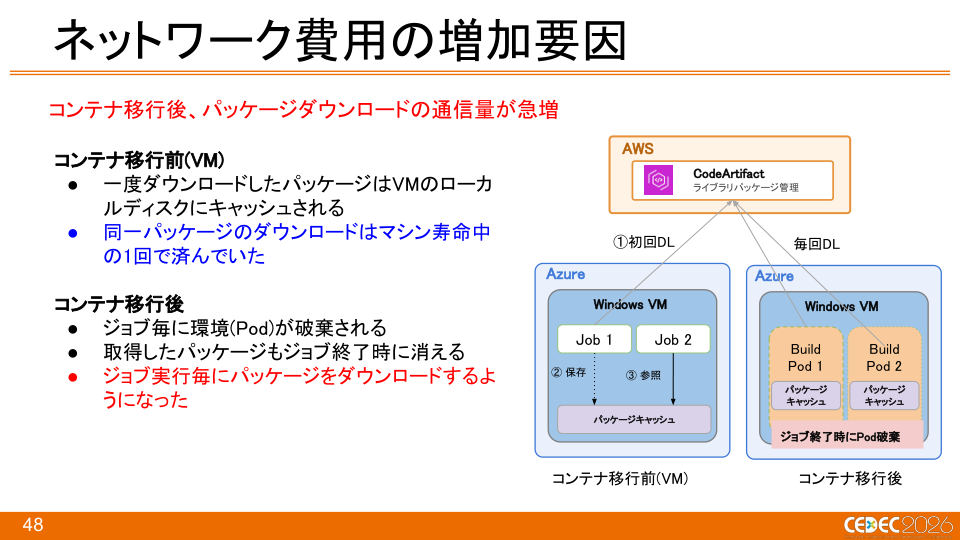
コンテナ移行後、パッケージダウンロードの通信量が急増 ネットワーク費用の増加要因 / AWS / CodeArtifact / ライブラリパッケージ管理 / Azure / コンテナ移行前(VM) / ①初回DL / Windows VM / Job 1 / Job 2 / パッケージキャッシュ / ② 保存 / ③ 参照 / Azure / コンテナ移行後 / Windows VM / Build / Pod 1 / Build / Pod 2 / パッケージ / キャッシュ / パッケージ / キャッシュ / ジョブ終了時にPod破棄 / コンテナ移行前(VM)
- 一度ダウンロードしたパッケージはVMのローカ ルディスクにキャッシュされる
- 同一パッケージのダウンロードはマシン寿命中 の1回で済んでいた / コンテナ移行後
- ジョブ毎に環境(Pod)が破棄される
- 取得したパッケージもジョブ終了時に消える
- ジョブ実行毎にパッケージをダウンロードするよ うになった / 毎回DL
容器迁移后,包下载的通信量急剧增加 网络费用增加因素 / AWS / CodeArtifact / 库包管理 / Azure / 容器迁移前(VM) / ①首次下载 / Windows VM / Job 1 / Job 2 / 包缓存 / ② 保存 / ③ 参照 / Azure / 容器迁移后 / Windows VM / Build / Pod 1 / Build / Pod 2 / 包 / 缓存 / 包 / 缓存 / 作业结束时Pod销毁 / 容器迁移前(VM)
- 一旦下载的包会被缓存在VM的本地磁盘上
- 同一包的下载在机器寿命中只需一次 / 容器迁移后
- 每个作业环境(Pod)都会被销毁
- 获取的包也会在作业结束时消失
- 每次执行作业都需要下载包 / 每次下载
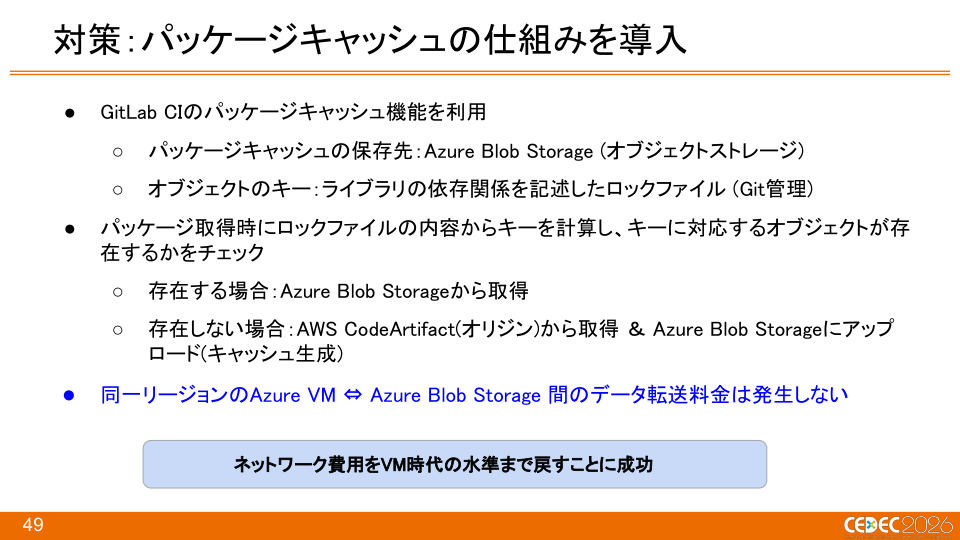
対策:パッケージキャッシュの仕組みを導入
- GitLab CIのパッケージキャッシュ機能を利用
- パッケージキャッシュの保存先:Azure Blob Storage (オブジェクトストレージ)
- オブジェクトのキー:ライブラリの依存関係を記述したロックファイル (Git管理)
- パッケージ取得時にロックファイルの内容からキーを計算し、キーに対応するオブジェクトが存 在するかをチェック
- 存在する場合:Azure Blob Storageから取得
- 存在しない場合:AWS CodeArtifact(オリジン)から取得 & Azure Blob Storageにアップ ロード(キャッシュ生成)
- 同一リージョンのAzure VM ⇔ Azure Blob Storage 間のデータ転送料金は発生しない ネットワーク費用をVM時代の水準まで戻すことに成功
对策:引入包缓存机制
- 利用GitLab CI的包缓存功能
- 包缓存的保存位置:Azure Blob Storage (对象存储)
- 对象的键:描述库依赖关系的锁文件 (Git管理)
- 获取包时,根据锁文件的内容计算键,并检查是否存在与键对应的对象
- 如果存在:从Azure Blob Storage获取
- 如果不存在:从AWS CodeArtifact(源)获取 & 上传到Azure Blob Storage(生成缓存)
- 同一区域内的Azure VM ⇔ Azure Blob Storage 之间的数据传输不产生费用 成功将网络费用恢复到VM时代的水平
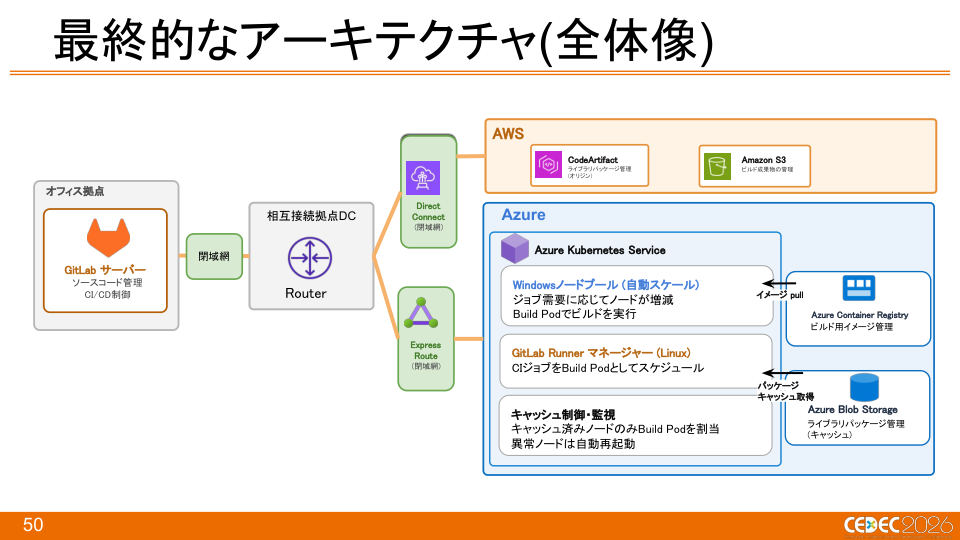
GitLab Runner マネージャー (Linux) CIジョブをBuild Podとしてスケジュール 最終的なアーキテクチャ(全体像) AWS / GitLab サーバー / ソースコード管理 / CI/CD制御 / CodeArtifact / ライブラリパッケージ管理 / (オリジン) / Amazon S3 / ビルド成果物の管理 / Express / Route / (閉域網) / Direct / Connect / (閉域網) / オフィス拠点 / 相互接続拠点DC / Azure Azure Kubernetes Service Router Windowsノードプール (自動スケール) ジョブ需要に応じてノードが増減 Build Podでビルドを実行 キャッシュ制御・監視 キャッシュ済みノードのみBuild Podを割当 異常ノードは自動再起動 Azure Container Registry ビルド用イメージ管理 Azure Blob Storage ライブラリパッケージ管理 / (キャッシュ) / イメージ pull / パッケージ / キャッシュ取得 / 閉域網
GitLab Runner 管理器 (Linux) 将CI作业作为Build Pod进行调度 最终架构(整体图) AWS / GitLab 服务器 / 源代码管理 / CI/CD控制 / CodeArtifact / 库包管理 / (源) / Amazon S3 / 构建产物管理 / Express / Route / (封闭网络) / Direct / Connect / (封闭网络) / 办公室据点 / 互连据点DC / Azure Azure Kubernetes Service Router Windows节点池 (自动伸缩) 根据作业需求增减节点 在Build Pod中执行构建 缓存控制・监控 仅将Build Pod分配给已缓存的节点 异常节点自动重启 Azure Container Registry 构建用镜像管理 Azure Blob Storage 库包管理 / (缓存) / 镜像拉取 / 包 / 缓存获取 / 封闭网络
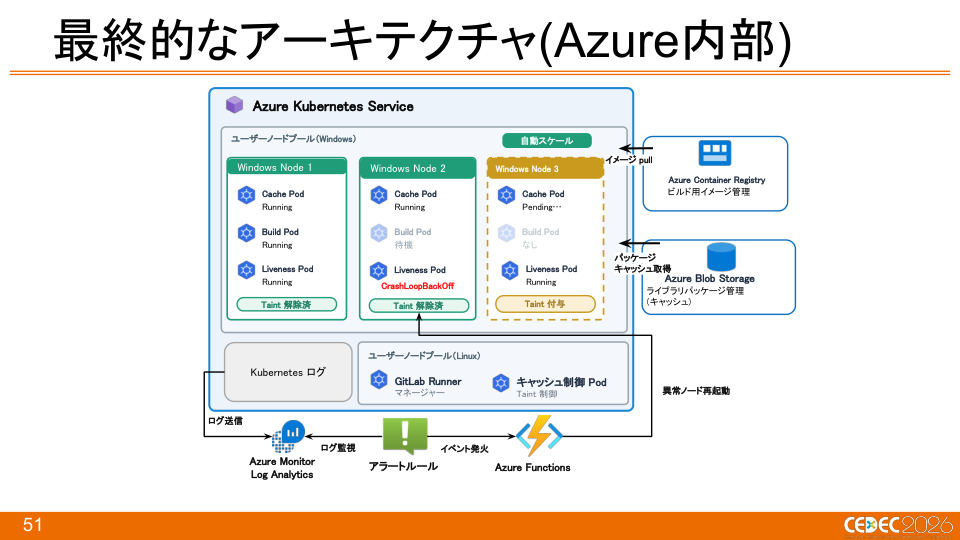
最終的なアーキテクチャ(Azure内部) Azure Container Registry ビルド用イメージ管理 Azure Blob Storage ライブラリパッケージ管理 / (キャッシュ) Azure Kubernetes Service ユーザーノードプール(Linux) GitLab Runner / マネージャー / キャッシュ制御 Pod / Taint 制御 ユーザーノードプール(Windows) 自動スケール / Windows Node 1 / Cache Pod / Running / Build Pod / Running / Taint 解除済 / Windows Node 2 / Cache Pod / Running / Build Pod / 待機 / Windows Node 3 / Cache Pod / Pending… / Build Pod / なし / Taint 付与 / イメージ pull / パッケージ / キャッシュ取得 / Liveness Pod / Running / Taint 解除済 / Liveness Pod CrashLoopBackOff Liveness Pod / Running / Azure Monitor / Log Analytics Azure Functions アラートルール / Kubernetes ログ / ログ監視 / イベント発火 / 異常ノード再起動 / ログ送信
最终架构(Azure内部) Azure Container Registry 构建用镜像管理 Azure Blob Storage 库包管理 / (缓存) Azure Kubernetes Service 用户节点池(Linux) GitLab Runner / 管理器 / 缓存控制 Pod / Taint 控制 用户节点池(Windows) 自动伸缩 / Windows Node 1 / Cache Pod / Running / Build Pod / Running / Taint 已解除 / Windows Node 2 / Cache Pod / Running / Build Pod / 等待 / Windows Node 3 / Cache Pod / Pending… / Build Pod / 无 / Taint 附加 / 镜像拉取 / 包 / 缓存获取 / Liveness Pod / Running / Taint 已解除 / Liveness Pod CrashLoopBackOff Liveness Pod / Running / Azure Monitor / Log Analytics Azure Functions 警报规则 / Kubernetes 日志 / 日志监控 / 事件触发 / 异常节点重启 / 日志发送
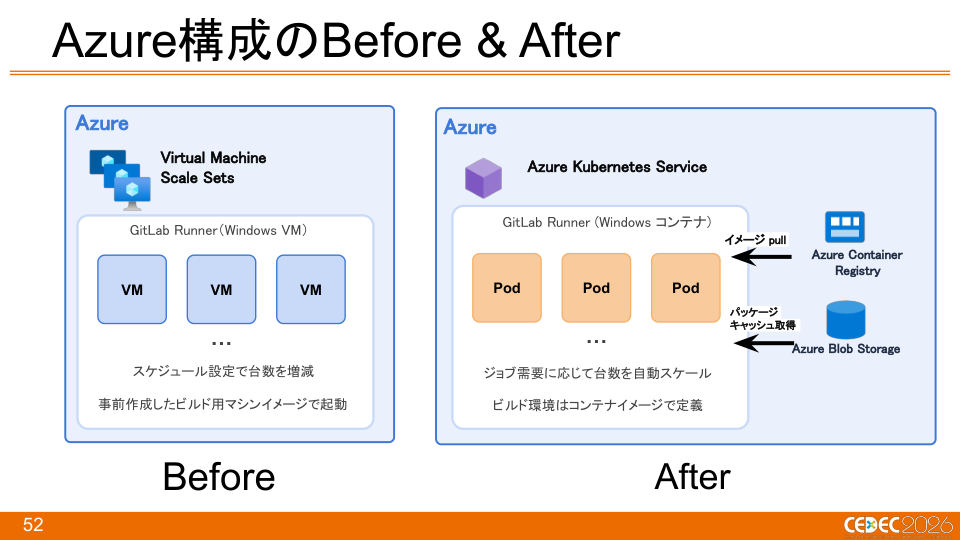
Azure構成のBefore & After Azure Virtual Machine Scale Sets GitLab Runner(Windows VM) VM / VM / VM / … / スケジュール設定で台数を増減 事前作成したビルド用マシンイメージで起動 Before / After / Azure Azure Kubernetes Service GitLab Runner (Windows コンテナ) Pod / Pod / Pod / … ジョブ需要に応じて台数を自動スケール ビルド環境はコンテナイメージで定義 Azure Container Registry Azure Blob Storage イメージ pull / パッケージ / キャッシュ取得
Azure架构的Before & After Azure Virtual Machine Scale Sets GitLab Runner(Windows VM) VM / VM / VM / … / 通过计划设置增减台数 使用预先创建的构建用机器镜像启动 Before / After / Azure Azure Kubernetes Service GitLab Runner (Windows 容器) Pod / Pod / Pod / … 根据作业需求自动伸缩台数 构建环境通过容器镜像定义 Azure Container Registry Azure Blob Storage 镜像拉取 / 包 / 缓存获取
导入成果・总结
成果① ビルド環境の更新作業にかかる時間が大幅短縮
- 従来はCI/CDのビルド環境更新のために1~2日要していた
- 今はDockerfileを作成・更新すると自動でコンテナイメージがコンテナレジ ストリにデプロイされる
- ジョブ側でイメージタグを更新すればビルド環境の切り替えが可能 1~2日かかる作業が2時間程度で終わるようになった
成果① 构建环境更新所需时间大幅缩短
- 以往更新CI/CD的构建环境需要1~2天
- 现在创建・更新Dockerfile后,容器镜像会自动部署到容器注册表
- 在作业侧更新镜像标签即可切换构建环境 原本需要1~2天的工作现在约2小时即可完成
成果② クラウド費用の削減効果
- コンピューティング費用が50%削減
- Windows VMを営業時間の台数固定 → ジョブ需要に応じた自動スケール
- バージョン更新時の検証用VM作成が不要に
- 以下のコストは増加したが、いずれも想定内
- Kubernetes(AKS)のコントロールプレーンの管理費用
- VMを停止状態で維持するためのOSディスクの維持費用
- コンテナレジストリのストレージの費用
- パッケージキャッシュのストレージの費用 Azure全体の費用として35%削減
成果② 云费用削减效果
- 计算费用削减50%
- Windows VM从营业时间固定台数 → 根据作业需求自动伸缩
- 版本更新时无需创建验证用VM
- 以下成本虽然增加,但均在预期内
- Kubernetes(AKS)控制平面的管理费
- 维持VM停止状态的OS磁盘维持费
- 容器注册表的存储费
- 包缓存的存储费 Azure整体费用削减35%
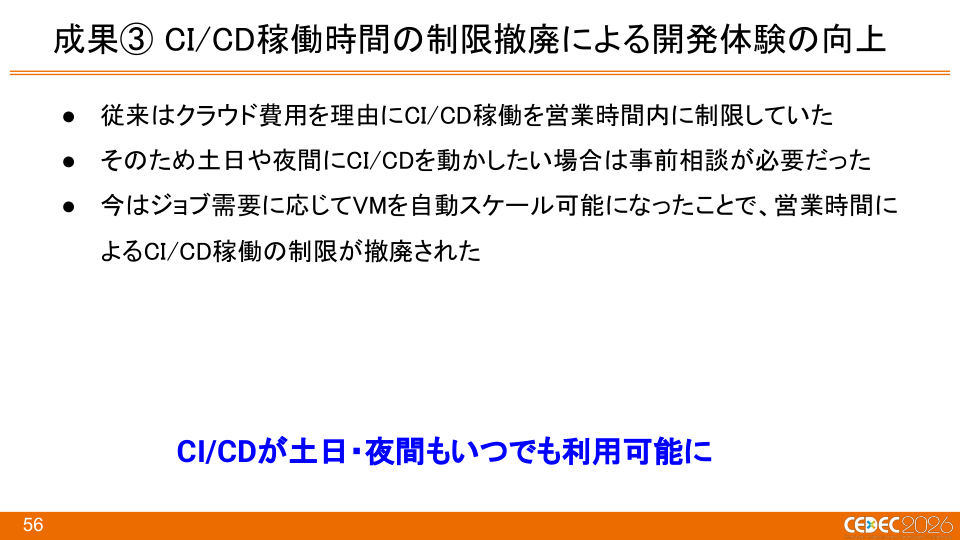
成果③ CI/CD稼働時間の制限撤廃による開発体験の向上
- 従来はクラウド費用を理由にCI/CD稼働を営業時間内に制限していた
- そのため土日や夜間にCI/CDを動かしたい場合は事前相談が必要だった
- 今はジョブ需要に応じてVMを自動スケール可能になったことで、営業時間に よるCI/CD稼働の制限が撤廃された CI/CDが土日・夜間もいつでも利用可能に
成果③ 通过取消 CI/CD 运行时间限制提升开发体验
- 以往出于云费用考虑,将 CI/CD 运行限制在营业时间内
- 因此若想在周末或夜间运行 CI/CD,需要事先协商
- 如今可根据作业需求自动扩缩 VM,从而取消了按营业时间限制 CI/CD 运行的做法 CI/CD 在周末、夜间也可随时使用
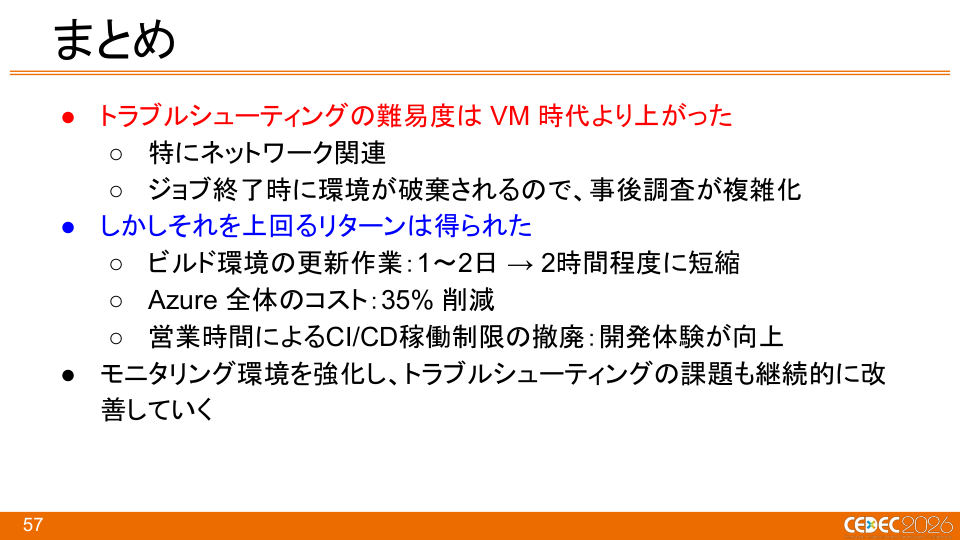
まとめ
- トラブルシューティングの難易度は VM 時代より上がった
- 特にネットワーク関連
- ジョブ終了時に環境が破棄されるので、事後調査が複雑化
- しかしそれを上回るリターンは得られた
- ビルド環境の更新作業:1〜2日 → 2時間程度に短縮
- Azure 全体のコスト:35% 削減
- 営業時間によるCI/CD稼働制限の撤廃:開発体験が向上
- モニタリング環境を強化し、トラブルシューティングの課題も継続的に改 善していく
总结
- 故障排查的难度相比 VM 时代有所上升
- 尤其是网络相关方面
- 由于作业结束时环境会被销毁,事后调查变得复杂
- 但获得了远超于此的回报
- 构建环境的更新作业:从 1〜2 天缩短至约 2 小时
- Azure 整体成本:削减 35%
- 取消按营业时间限制 CI/CD 运行:开发体验得到提升
- 将强化监控环境,并持续改善故障排查方面的课题
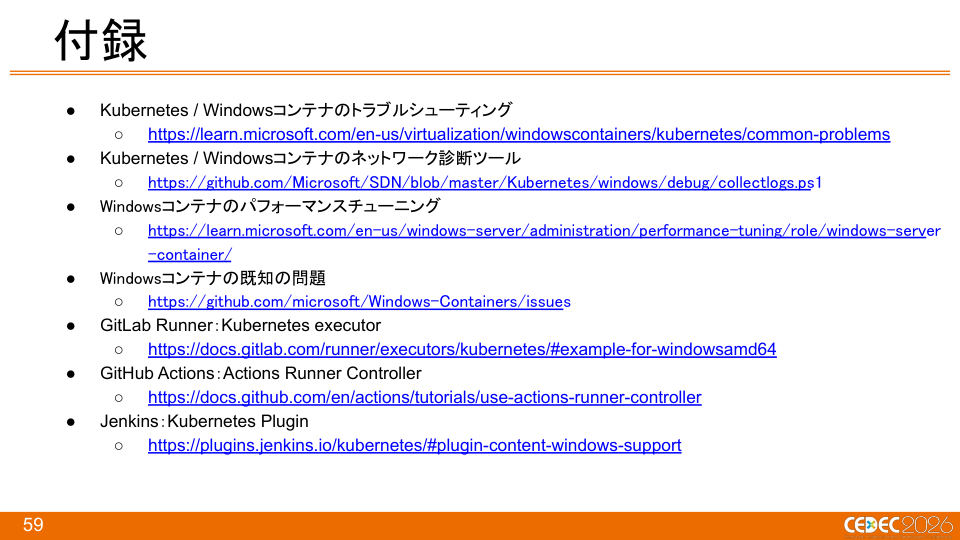
- Kubernetes / Windowsコンテナのトラブルシューティング
- https://learn.microsoft.com/en-us/virtualization/windowscontainers/kubernetes/common-problems
- Kubernetes / Windowsコンテナのネットワーク診断ツール
- https://github.com/Microsoft/SDN/blob/master/Kubernetes/windows/debug/collectlogs.ps1
- Windowsコンテナのパフォーマンスチューニング
- https://learn.microsoft.com/en-us/windows-server/administration/performance-tuning/role/windows-server
- container/
- Windowsコンテナの既知の問題
- https://github.com/microsoft/Windows-Containers/issues
- GitLab Runner:Kubernetes executor
- https://docs.gitlab.com/runner/executors/kubernetes/#example-for-windowsamd64
- GitHub Actions:Actions Runner Controller
- https://docs.github.com/en/actions/tutorials/use-actions-runner-controller
- Jenkins:Kubernetes Plugin
- https://plugins.jenkins.io/kubernetes/#plugin-content-windows-support 付録
- Kubernetes / Windows 容器的故障排查
- https://learn.microsoft.com/en-us/virtualization/windowscontainers/kubernetes/common-problems
- Kubernetes / Windows 容器的网络诊断工具
- https://github.com/Microsoft/SDN/blob/master/Kubernetes/windows/debug/collectlogs.ps1
- Windows 容器的性能调优
- https://learn.microsoft.com/en-us/windows-server/administration/performance-tuning/role/windows-server
- container/
- Windows 容器的已知问题
- https://github.com/microsoft/Windows-Containers/issues
- GitLab Runner:Kubernetes executor
- https://docs.gitlab.com/runner/executors/kubernetes/#example-for-windowsamd64
- GitHub Actions:Actions Runner Controller
- https://docs.github.com/en/actions/tutorials/use-actions-runner-controller
- Jenkins:Kubernetes Plugin
- https://plugins.jenkins.io/kubernetes/#plugin-content-windows-support 附录